Краткая аннотация
Одна неправильная проверка в скрипте превратила обычное обновление клиентской базы в небольшой производственный инцидент. Несколько сотен записей получили неверный статус, часть клиентов успела получить автоматические уведомления, а исправить всё незаметно уже не получалось. Обычно в такой ситуации я сначала пыталась бы самостоятельно вернуть систему в исходное состояние и только потом рассказать коллегам. В этот раз я сделала наоборот. И неожиданно именно признание ошибки позволило устранить её быстрее и спокойнее.
Введение
Самые неприятные ошибки на работе у меня происходили не тогда, когда я чего-то совсем не знала. Наоборот, обычно я ошибалась в задачах, которые казались настолько знакомыми, что переставала относиться к ним как к потенциально опасным.
В тот день нужно было обновить статусы клиентов после переноса части данных между CRM и нашей внутренней системой. Процесс был полуавтоматическим: данные выгружались в PostgreSQL, небольшой скрипт сопоставлял записи, рассчитывал новое состояние клиента и отправлял изменения обратно через API. Я уже запускала похожую процедуру несколько раз и поэтому не воспринимала её как что-то особенно рискованное.
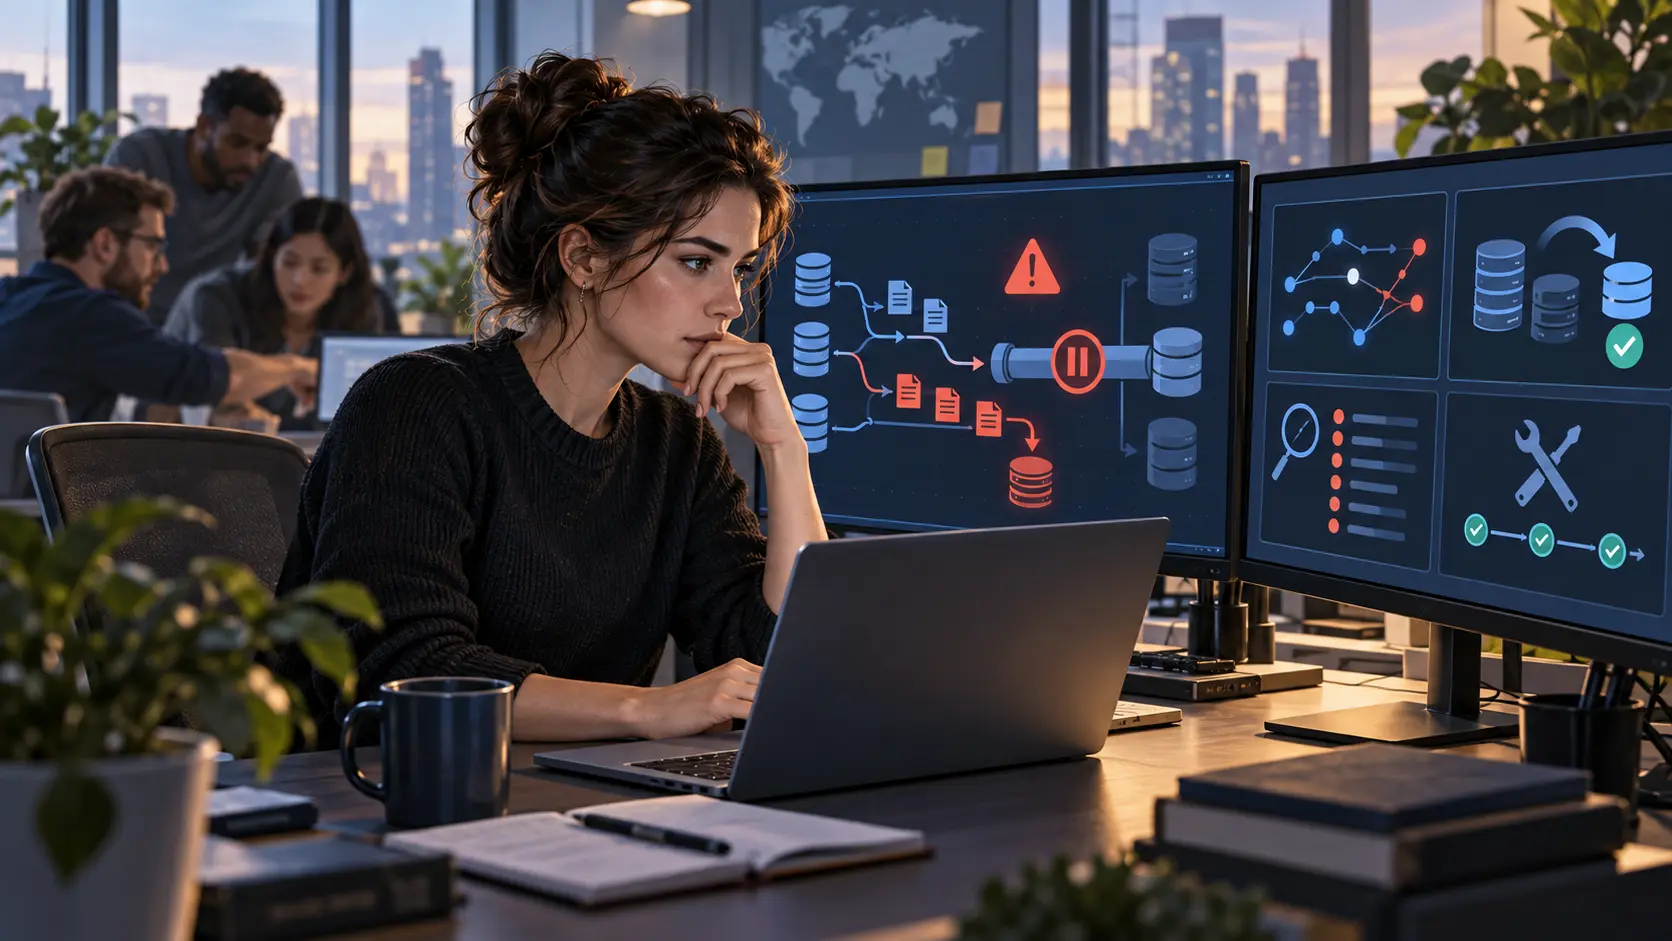
Примерно через двадцать минут после запуска я увидела цифру, которой там быть не должно было. Количество клиентов со статусом просроченной оплаты выросло почти втрое. Через минуту пришло сообщение от менеджера: почему клиент, который оплатил счёт утром, получил напоминание о задолженности. В этот момент стало понятно, что ошибка уже вышла за пределы моего ноутбука.
1. Ошибка была в одной строке, но проблема оказалась намного шире
Причина выглядела почти смешно. В системе существовали две даты: дата выставления счёта и дата окончания периода оплаты. Во время последнего изменения схемы второе поле стало приходить через API в UTC, а часть старых записей продолжала храниться с локальным смещением.
Мой скрипт приводил дату к одному формату, но сравнивал её с текущим временем раньше, чем применял смещение. На тестовой выборке это почти никак себя не проявляло: я проверяла свежие записи, созданные уже после обновления. На реальной базе осталась смесь старого и нового формата.
Условие было простым: если срок оплаты меньше текущего времени и подтверждённого платежа нет, клиент переводится в просрочку. Но для части записей срок фактически сдвинулся на несколько часов назад. Этого хватило, чтобы 437 клиентов получили неправильный внутренний статус. У 126 из них следующий процесс уже успел поставить автоматическое уведомление в очередь.
Самое неприятное было даже не в этих 437 строках. Статус клиента использовался сразу несколькими системами. Его читала CRM, модуль уведомлений и внутренний отчёт отдела продаж. Один неверно рассчитанный атрибут начал расползаться дальше.
Я остановила задачу, но к этому моменту часть событий уже оказалась в очереди. Простого возврата значения в базе было недостаточно. Даже если бы я моментально исправила все строки, уже созданные события продолжали существовать.
И вот здесь у меня появилась очень знакомая мысль: сейчас быстро всё починю, а потом расскажу.
Раньше я именно так и делала.
Мне казалось, что профессиональный сотрудник должен приносить руководителю уже решённую проблему. Сообщить об ошибке до того, как знаешь способ исправления, означало для меня признать, что ты потеряла контроль.
На этот раз я посмотрела на очередь уведомлений и поняла, что попытка выиграть десять минут вполне может стоить нам ещё сотни неправильных сообщений.
Я написала руководителю и двум коллегам, которые отвечали за CRM и уведомления. Коротко: запущено ошибочное обновление, затронуты клиентские статусы, автоматическая задачу остановила, точный масштаб проверяю.
Никакого красивого объяснения причины у меня тогда ещё не было.
И это оказалось правильным решением.
2. Мы не начали исправлять данные сразу — сначала зафиксировали состояние системы
Первым желанием было выполнить обратный UPDATE и вернуть старые статусы. Коллега остановил меня буквально одним вопросом: откуда я точно знаю, какими они были для каждой записи до запуска?
И ответа у меня не было.
Большая часть статусов действительно должна была вернуться в прежнее состояние. Но за те двадцать минут, пока работал мой скрипт, могли пройти настоящие платежи, изменения менеджеров и другие автоматические операции. Если просто заменить всем затронутым клиентам статус на предыдущий из утренней выгрузки, можно было уничтожить уже корректные изменения.
Мы временно заморозили связанные процессы и начали не с исправления, а с реконструкции событий.
У нас оказалось четыре источника, по которым можно было восстановить картину:
- лог запуска с идентификаторами обработанных записей;
- история изменений CRM с предыдущим и новым значением поля;
- журнал платежных событий;
- очередь уведомлений с временем создания каждого задания.
Это был первый момент, когда я по-настоящему оценила разницу между резервной копией и историей изменений. Резервная копия отвечает на вопрос, как выглядела база в конкретный момент. Но нам нужно было понять, что произошло с отдельной записью между двумя моментами.
Мы собрали затронутые ID во временную таблицу и разделили их на группы. Одни клиенты вообще не менялись после ошибочного запуска. Для них откат был простым. У других после моей операции уже произошла настоящая оплата. Их нельзя было возвращать к старому значению. Отдельно пришлось обработать записи, которые успели попасть в очередь уведомлений.
Перед исправлением я написала проверочный запрос, который ничего не изменял, а только показывал предполагаемый результат. На 437 затронутых записях получилось несколько разных сценариев:
- 291 запись можно было безопасно вернуть к прежнему состоянию;
- 103 записи уже имели более новое корректное событие и не требовали отката;
- 43 записи пришлось проверять по журналу операций отдельно.
Цифры здесь оказались важнее моего первоначального ощущения, что я просто испортила несколько сотен статусов.
Если бы я сразу сделала массовый обратный UPDATE, то исправила бы одну ошибку и создала другую.
С уведомлениями ситуация была ещё интереснее. Очередь работала асинхронно. Создание задания и фактическая отправка происходили не одновременно. Поэтому мы отдельно нашли задания с ошибочными ID, удалили ещё не обработанные и посмотрели журнал уже выполненных.
В результате часть сообщений удалось остановить до отправки. Те, которые уже ушли, пришлось признать отдельным последствием инцидента, а не пытаться делать вид, что ничего не произошло.
Мне было неприятно видеть этот список. Там находились реальные клиенты, которые получили сообщение из-за моей ошибки. Но психологически после того, как проблема стала общей и измеримой, работать с ней стало почему-то легче.
До этого в голове была одна огромная мысль: я всё сломала.
После разбора появились конкретные сущности: 437 записей, очередь, несколько типов состояний, журнал событий и понятный порядок восстановления.
С техническими проблемами обычно проще работать именно в таком виде.
3. После исправления мы разбирали не мою невнимательность, а систему, которая позволила одной ошибке пройти так далеко
К вечеру данные были приведены в порядок. На следующий день мы вернулись к самому неприятному вопросу: почему это вообще стало возможным.
Можно было закончить разбор фразой о том, что мне следовало внимательнее проверить формат даты. Формально это было правдой. Но такое объяснение ничего не меняло бы. Через месяц кто-нибудь другой мог сделать похожую ошибку уже с другим полем.
Мы прошли всю цепочку и нашли несколько мест, где процесс слишком сильно рассчитывал на человека:
- тестовая выборка содержала только новые записи и не проверяла старый формат данных;
- скрипт позволял сразу обработать всю выборку без промежуточного лимита;
- изменение статуса автоматически запускало следующий бизнес-процесс;
- перед массовым обновлением не формировался отчёт с количеством записей по старому и новому состоянию;
- для опасной операции не существовало режима, который выполнял расчёт без записи результата.
После этого я переделала саму процедуру.
Теперь первый запуск работает как dry run. Скрипт рассчитывает изменения, но не отправляет их в API. На выходе я получаю количество затронутых записей, распределение по статусам и небольшой набор примеров. Если вчера просроченных клиентов было около двухсот, а предварительный расчёт внезапно показывает семьсот, это становится видно до изменения данных.
Для массовых операций появился порог. Если количество затронутых записей превышает ожидаемый диапазон, выполнение останавливается и требует отдельного подтверждения. Это не сложная технология, но раньше её просто не было.
Ещё одно изменение оказалось важнее всех остальных. Мы разделили изменение данных и побочное действие. Раньше новый статус почти сразу мог породить задачу на отправку сообщения. Теперь событие сначала сохраняется, проходит дополнительную проверку, и только после этого его забирает обработчик уведомлений.
По сути, мы добавили расстояние между ошибкой и её внешним последствием.
Я также стала использовать идентификатор операции для массовых изменений. Каждая запись теперь хранит, каким запуском она была изменена. Если что-то снова пойдёт не так, не придётся восстанавливать список затронутых клиентов по нескольким журналам. Можно будет выбрать всё, что относится к конкретной операции.
Но самый неожиданный результат был не техническим.
На разборе никто не задавал вопрос, как я вообще могла такое сделать. Гораздо больше времени ушло на обсуждение того, почему система позволяла одной ошибке сразу менять сотни записей и запускать внешние действия без дополнительной проверки.
Тогда я впервые нормально поняла довольно неприятную вещь: пытаясь скрывать рабочие ошибки, я раньше защищала не систему и даже не результат. Я защищала своё представление о себе как о человеке, который не ошибается.
А это довольно дорогая защита.
Вывод
После этого случая я не стала человеком, который радостно сообщает коллегам о каждой своей ошибке. Мне всё ещё неприятно обнаруживать, что проблема появилась из-за моего решения. И первые несколько секунд я по-прежнему хочу самостоятельно всё исправить, желательно так, чтобы никто даже не заметил.
Но теперь у меня есть довольно простой критерий. Если ошибка уже может затронуть чужую работу, клиентов, деньги или данные, момент для тихого самостоятельного ремонта закончился.
В той ситуации признание ошибки не увеличило проблему. Оно, наоборот, ограничило её размер. Один человек остановил меня от неправильного отката, другой помог разобраться с очередью, а история изменений позволила восстановить данные без догадок.
С тех пор я намного осторожнее отношусь не к самим ошибкам, а к процессам, в которых ошибка одного человека сразу становится необратимой.
Хорошая рабочая система, как я теперь понимаю, строится не на предположении, что сотрудники всегда внимательны. Она должна учитывать, что однажды кто-то перепутает формат даты, запустит не тот скрипт, выберет слишком широкую выборку или нажмёт кнопку раньше времени.
В тот день этим человеком оказалась я.
И впервые мне не пришлось сначала изображать, что всё под контролем, чтобы потом начать действительно возвращать ситуацию под контроль.
У меня был похожий опыт, выводы очень близкие. Спасибо за подробности.
Главная мысль попала точно. Такие материалы хочется обсуждать, а не просто пролистывать.
Вот это уже похоже на практичный опыт. Сохранил себе, вернусь позже перечитать.